
Googlebot e SEO: Atualizar o Site Faz o Google Rastreá-lo Mais?
▼ Em resumo
Atualizar o site faz o Googlebot rastreá-lo mais?
Páginas que mudam com frequência podem justificar rastreamentos de atualização mais frequentes, enquanto páginas que permanecem estáticas podem ser revisitadas com menor frequência. Isso não significa que modificar uma página apenas para atrair o Googlebot melhore seu ranking. O Google ajusta automaticamente sua atividade de rastreamento e afirma que ser rastreado com maior frequência não significa necessariamente obter melhores posições.[1][2]
Uma loja física dificilmente mantém a mesma vitrine durante meses. Produtos mudam, promoções terminam, novas coleções chegam e determinados itens passam a merecer maior destaque.
Na internet, apesar de toda a tecnologia envolvida, a lógica não deveria ser muito diferente.
Quando este artigo foi publicado originalmente, uma das recomendações era manter o site atualizado. Em um e-commerce, isso poderia significar mudar banners, produtos e promoções da homepage conforme a própria loja mudava. Em um site de conteúdo, a publicação de um novo artigo também alterava naturalmente a Home e as páginas de categorias.
A ideia era simples: se uma página muda, o Google precisa voltar a rastreá-la para descobrir a nova versão.
Anos depois, sabemos muito mais sobre como o Googlebot funciona. E o interessante é que o princípio continua válido. O que precisa ser refinado é a relação entre atualização, frequência de rastreamento, indexação e ranking.
Nota editorial: Este artigo foi publicado originalmente em [2024] e foi substancialmente revisado e atualizado em agosto de 2026. A versão atual preserva a tese original sobre atualização de sites e rastreamento pelo Googlebot, incorporando o que aprendemos desde então sobre crawling, Search e inteligência artificial.
O que é Googlebot e por que ele precisa voltar ao site?
Googlebot é o nome genérico dos crawlers do Google responsáveis por acessar páginas e outros recursos disponíveis na web.
Mas a internet não é estática. Produtos aparecem e desaparecem, preços mudam, notícias são publicadas, artigos são atualizados e páginas recebem novos links.
Por isso, o Google não precisa apenas descobrir URLs. Também precisa retornar às URLs que já conhece para verificar se algo mudou.
Em sua documentação sobre crawl budget, o Google explicou que a demanda de rastreamento leva em consideração fatores como popularidade e staleness. Seus sistemas procuram evitar que URLs fiquem desatualizadas no índice.[1]
É aqui que chegamos a uma ideia que continua relevante.
Seu site também tem uma vitrine
Imagine um e-commerce.
Uma nova coleção chega. A homepage passa a destacar os novos produtos, o banner da campanha muda, uma promoção termina e outros itens ganham destaque.
A Home realmente mudou.
Não estamos falando de trocar uma palavra ou modificar a data da página para tentar convencer o Google de que existe algo novo.
A representação digital da empresa mudou porque o próprio negócio mudou.
O mesmo acontece em sites de conteúdo.
Imagine que uma homepage mostre os três artigos mais recentes:
Artigo C
Artigo B
Artigo A
Um novo conteúdo é publicado e ela passa a apresentar:
Artigo D — novo
Artigo C
Artigo B
Não foi apenas o Artigo D que surgiu.
A própria homepage mudou. Pode ter recebido novo título, imagem, resumo e, principalmente, um novo link interno para uma URL que o crawler ainda precisa descobrir.
Páginas de categorias, notícias, blogs e hubs editoriais funcionam de maneira semelhante.
Uma página central que muda naturalmente também pode funcionar como um importante ponto de descoberta de conteúdo novo.
Atualizar o site melhora o ranking no Google?
Aqui está uma distinção fundamental: atualização, rastreamento e ranking não são a mesma coisa.
Em 2022, representantes do Google discutiram publicamente a possibilidade de reduzir refresh crawls desnecessários. Gary Illyes explicou a diferença entre crawling para descobrir novos conteúdos e crawling para revisitar documentos já conhecidos.[2]
O exemplo utilizado foi muito parecido com o princípio que estamos discutindo.
A homepage do Wall Street Journal muda constantemente e, portanto, justifica muitos refresh crawls. Uma página “Quem somos”, que muda muito menos, não precisa necessariamente ser revisitada com a mesma frequência.[2]
Mas dessa mesma discussão veio um esclarecimento importante: mais crawling não significa melhor ranking.
Portanto, podemos pensar assim:
Mudanças reais → podem criar necessidade de novo rastreamento.
Novo rastreamento → permite encontrar a versão atualizada.
Isso não significa que atualizar e melhorar uma página não possa contribuir para melhores resultados. Se uma atualização torna o conteúdo mais completo, correto, útil ou relevante para determinada pesquisa, a nova versão pode ter melhores condições de classificação. O benefício, porém, está na qualidade e relevância da mudança — não simplesmente no fato de o Googlebot ter visitado a página novamente.
Essa distinção é muito mais clara hoje do que quando este artigo foi escrito originalmente.
E o HTTP 304 Not Modified?
Existe também uma parte técnica importante nessa história.
Quando um crawler retorna a determinado recurso, mecanismos HTTP podem ajudar a verificar se ele realmente mudou.
Quando apropriado, o servidor pode responder:
304 Not Modified
Em termos simples:
“Este recurso não mudou desde a versão que você já conhece.”
Isso pode evitar transferências desnecessárias e tornar a comunicação entre crawler e servidor mais eficiente.
Portanto, um 304 Not Modified não representa algo negativo para SEO. Ele simplesmente informa que não há uma nova versão daquele recurso a ser transferida.
O Googlebot ficou cada vez mais automático
Durante muitos anos, proprietários de sites tinham acesso a uma ferramenta do Search Console que permitia limitar manualmente a taxa de rastreamento.
Em novembro de 2023, o Google anunciou que essa ferramenta seria descontinuada em janeiro de 2024.[3]
A justificativa é especialmente interessante para esta discussão.
Segundo o Google, melhorias realizadas em sua lógica de rastreamento haviam reduzido a utilidade do controle manual. O Googlebot já conseguia reagir automaticamente ao comportamento do servidor, diminuindo sua atividade quando encontrava problemas como respostas mais lentas ou determinados erros.[3]
A documentação atual continua explicando que a taxa ideal de rastreamento é determinada algoritmicamente.[4]
Ou seja, o processo tornou-se progressivamente mais automatizado.
E é justamente aqui que aparece uma coincidência histórica que considero particularmente interessante.
O Googlebot mudou enquanto a inteligência artificial avançava
Quando este artigo foi escrito originalmente, inteligência artificial não fazia parte da conversa cotidiana sobre SEO como acontece hoje.
Olhando retrospectivamente, porém, a meu ver é difícil ignorar que duas transformações caminharam paralelamente.
Em 2019, o Google introduziu BERT na Pesquisa, um avanço importante no uso de redes neurais para compreender linguagem, contexto e intenção das consultas.[5]
Em 2021, apresentou o MUM — Multitask Unified Model — como um novo marco de inteligência artificial para compreender informações e ajudar em necessidades de pesquisa mais complexas.[6]
Em 2022, representantes do Google discutiam tornar os refresh crawls mais eficientes, evitando visitas desnecessárias a páginas que pouco mudavam.[2]
Em 2023, o Google anunciou que os avanços no processamento automático da taxa de rastreamento tornariam desnecessário o antigo Crawl Rate Limiter.[3]
No mesmo ano aconteceu algo muito maior: o Google apresentou a Search Generative Experience (SGE) e afirmou que os avanços da IA generativa permitiam “reimaginar” o que um mecanismo de busca poderia fazer.[7]
E em 2024, essa transformação ganhou escala. As AI Overviews foram expandidas para mais de 100 países e territórios, com previsão do próprio Google de atingir mais de um bilhão de usuários por mês.[8]
Duas evoluções que caminharam em paralelo
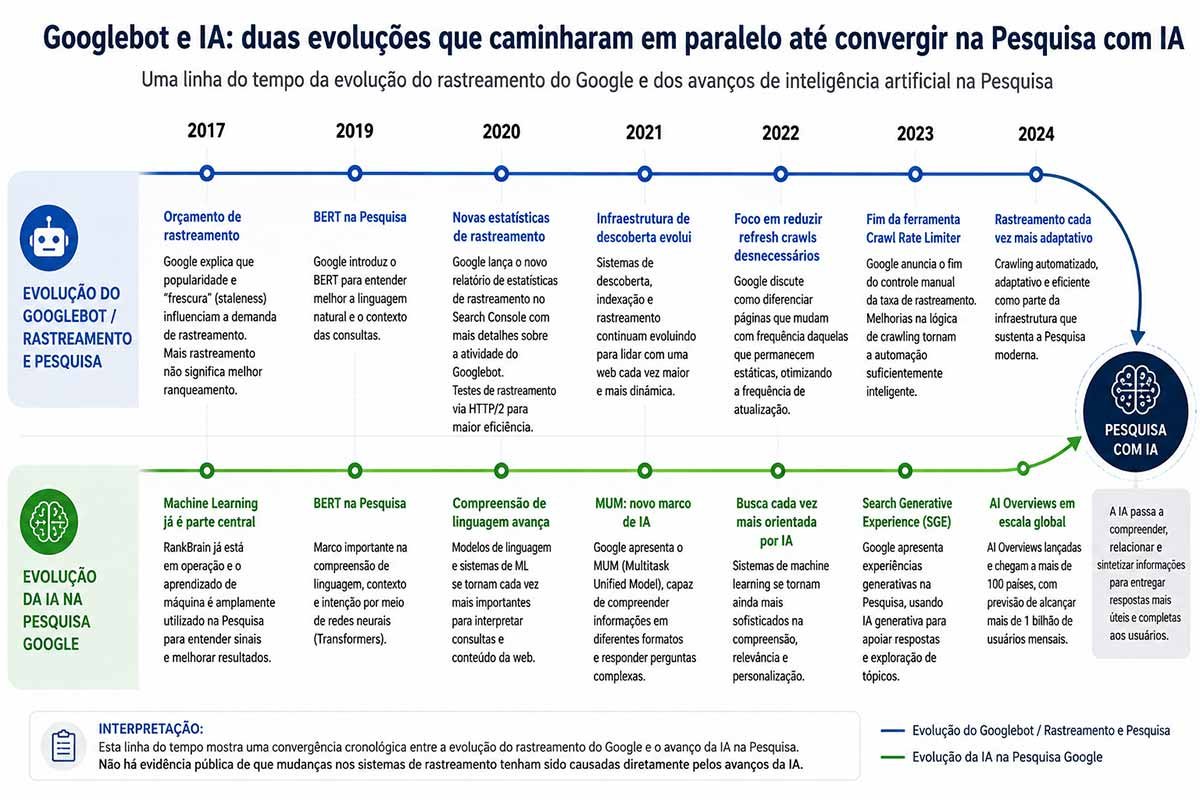
| Ano | Rastreamento / infraestrutura | Inteligência artificial / Search |
|---|---|---|
| 2017 | Google documenta crawl rate, crawl demand e staleness.[1] | Machine learning já fazia parte da Pesquisa. |
| 2019 | Crawling continua sendo a porta de entrada para descoberta e indexação. | BERT amplia a compreensão de linguagem e contexto.[5] |
| 2021 | Infraestrutura de descoberta e indexação continua evoluindo. | Google apresenta MUM.[6] |
| 2022 | Discussão sobre redução de refresh crawls desnecessários.[2] | Machine learning assume papel crescente na compreensão das pesquisas. |
| 2023 | Google anuncia o fim do Crawl Rate Limiter devido à maior automação.[3] | SGE leva IA generativa diretamente à Pesquisa.[7] |
| 2024 | Crawling permanece como infraestrutura fundamental de descoberta. | AI Overviews chegam a mais de 100 países.[8] |
Não existe evidência pública de que o Google tenha modificado seus sistemas de crawling especificamente para preparar a chegada da AI Search.
Portanto, não afirmo que uma transformação tenha causado a outra.
Minha interpretação é que a coincidência cronológica merece atenção.
Enquanto o Google tornava mais sofisticada e automatizada a maneira como descobria e atualizava informações da web, desenvolvia paralelamente sistemas de inteligência artificial cada vez mais capazes de compreender, relacionar e utilizar essas informações.
O que a AI Search muda nessa história?
Durante muito tempo, podíamos representar o processo de maneira bastante simplificada:
Crawling → Indexação → Ranking → Resultados
Hoje, o ecossistema é muito mais sofisticado.
Sistemas de inteligência artificial participam da compreensão de linguagem, contexto e relações entre informações e, mais recentemente, da geração de respostas e resumos apresentados diretamente na Pesquisa.[7][8]
Mas existe um princípio que atravessa as duas eras:
Para trabalhar com informação atual, primeiro é necessário ter acesso à informação atual.
Isso não significa que trocar um banner fará uma empresa aparecer em uma AI Overview.
Significa algo muito mais fundamental: se o negócio mudou, sua presença digital deveria refletir essa mudança.
Então ainda devemos atualizar nossos sites?
Sim. Mas não para enganar o Googlebot.
Uma loja deve renovar sua vitrine digital quando surgem novos produtos, campanhas e prioridades.
Um portal deve apresentar suas notícias recentes.
Um site editorial deve incorporar novos artigos à homepage e às páginas de categorias.
E conteúdos antigos devem ser atualizados quando suas informações deixarem de representar a realidade.
Um site ativo produz naturalmente mudanças que usuários e mecanismos de busca precisam descobrir.
A tecnologia mudou profundamente desde a publicação original deste artigo. O Googlebot ficou mais automatizado, machine learning transformou a compreensão das pesquisas e a IA generativa começou a transformar a própria apresentação das respostas.
Mas uma ideia permanece surpreendentemente atual: Um site deve acompanhar a realidade do negócio ou da informação que representa.
A vitrine mudou. O Google mudou. A inteligência artificial chegou.
Não atualize seu site para parecer atualizado ao Google. Atualize-o porque seu negócio, seu conteúdo e o mundo mudam. Quando a atualização torna a página mais útil, relevante e atual, o rastreamento permite que o Google descubra justamente essas melhorias.
Manter a informação realmente atualizada continua fazendo sentido — talvez hoje por mais razões do que quando este artigo foi escrito pela primeira vez.
Fontes e referências
[1] Google Search Central — 2017. O que a cota de rastreamento significa para o Googlebot. Documento histórico do Google sobre crawl rate, crawl demand, popularidade, staleness e a distinção entre crawling e ranking.
Google Search Central — O que a cota de rastreamento significa para o Googlebot ↗
[2] Search Engine Journal — 20 de janeiro de 2022. Google Considers Reducing Webpage Crawl Rate. Registra a discussão de Gary Illyes, John Mueller e Martin Splitt sobre discovery crawls, refresh crawls e o esclarecimento de que maior frequência de crawling não significa melhor ranking.
Search Engine Journal — Google Considers Reducing Webpage Crawl Rate ↗
[3] Google Search Central — 24 de novembro de 2023. Em breve: descontinuação da ferramenta de limitação de taxa de rastreamento no Search Console. O Google atribui a decisão às melhorias na lógica e no processamento automatizado da taxa de rastreamento.
Google — Descontinuação do Crawl Rate Limiter ↗
[4] Google for Developers. Reduzir a taxa de rastreamento do Google. Documentação sobre o controle algorítmico da taxa de crawling e como o Googlebot reage aos servidores.
Google — Documentação atual sobre taxa de rastreamento ↗
[5] Google — 25 de outubro de 2019. Understanding searches better than ever before. Apresentação do BERT no Google Search e sua aplicação à compreensão de linguagem e contexto.
Google — BERT e a compreensão das pesquisas ↗
[6] Google — 18 de maio de 2021. MUM: A new AI milestone for understanding information. Apresentação do Multitask Unified Model e de sua capacidade de compreender informações mais complexas.
Google — MUM: A New AI Milestone ↗
[7] Google — 10 de maio de 2023. Supercharging Search with generative AI. Anúncio da Search Generative Experience e da integração experimental da IA generativa à Pesquisa Google.
Google — Supercharging Search with Generative AI ↗
[8] Google — 28 de outubro de 2024. AI Overviews in Search are coming to more places around the world. Expansão das AI Overviews para mais de 100 países e territórios, com alcance projetado acima de um bilhão de usuários mensais.
Google — AI Overviews expandem para mais de 100 países ↗
